技術情報
企業の RAG ナレッジベースはどう作る?データ準備・権限・精度・費用
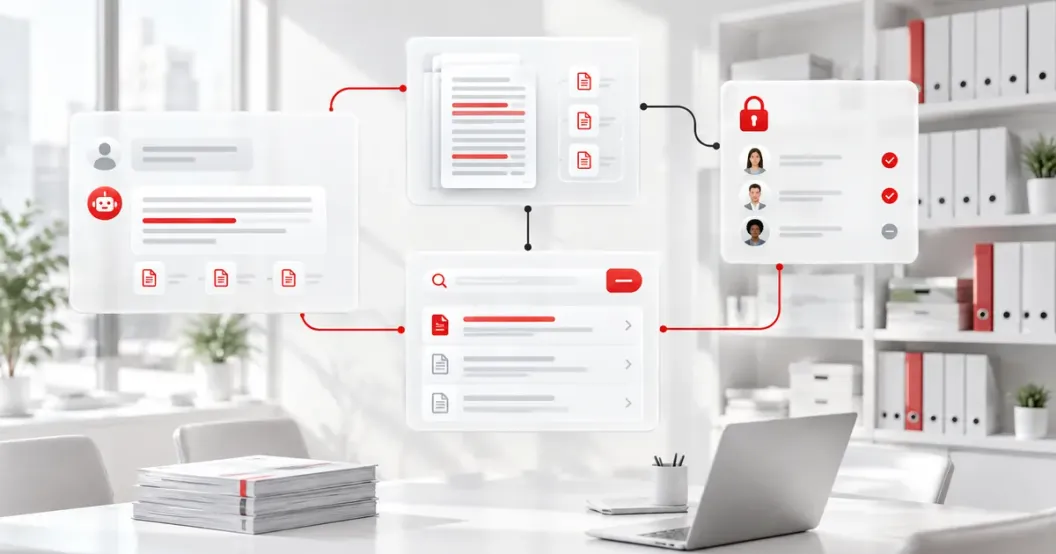
企業の RAG ナレッジベースは、AI がまず自社の文書から関連する箇所を探し、その箇所に基づいて回答し、出典を示す仕組みです。使えるかどうかを決めるのはモデル選びではなく、文書の整理、権限による絞り込み、実際の質問による精度検証、運用開始後の保守計画の 4 点です。本記事では、向いている用途、データ準備、権限と個人情報、受け入れテストの方法、プロジェクト段階ごとの費用と期間を整理します。
この記事の要点
- RAG(検索拡張生成)は、AI がまず社内文書を検索し、取得した箇所に基づいて回答する仕組みで、出典を示せるうえ、文書を更新してもモデルの再学習は不要です。
- RAG ナレッジベースの精度は主に文書の品質で決まり、古い版、重複文書、スキャン画像を整理しないままでは、より高性能なモデルでも正しく答えられません。
- 権限は検索の段階で絞り込む必要があり、利用者が閲覧できない文書が AI の回答に入ると、ナレッジベースが情報漏えいの経路になります。
- 受け入れテストでは、同じ実際の質問セットで回答精度、出典の正確さ、適切に回答を控えるかを測り、デモ用に選んだ質問だけで判断しないことが重要です。
- JoinX の台湾における受託開発の相場では、単一用途の PoC は約 30 万〜80 万台湾ドル、本番運用は約 80 万〜250 万台湾ドルで、モデル API とサーバー費用は利用量に応じて別途かかります。
目次
企業の RAG ナレッジベースが使えるかどうかは、モデルではなく文書と権限でほぼ決まります。 RAG(Retrieval-Augmented Generation、検索拡張生成)は、AI が回答の前に自社の文書を調べ、見つけた箇所に基づいて回答し、出典を示す仕組みです。以下では、意思決定者がよく尋ねる順に、向いている用途、準備するもの、権限の設定、検証方法、費用を整理します。
企業の RAG ナレッジベースとは? ChatGPT をそのまま使うのと何が違う?
RAG ナレッジベースは、AI がまず社内文書から関連箇所を探し、その箇所に基づいて出典付きで回答する仕組みです。ChatGPT にそのまま尋ねる場合はモデルの学習データに頼るため、社内規定を知らず、回答の根拠も示せません。
この手法は 2020 年に Facebook AI Research の Lewis らが論文で提案したもので、モデルが回答時に外部の知識を参照でき、知識を更新してもモデルを再学習しなくて済むことを狙いとしています。企業にとっての外部知識とは、業務マニュアル、製品仕様、法令通知、問い合わせ FAQ といった文書です。
| 方法 | 回答の根拠 | 文書を更新したとき | 出典を示せるか | 向いている用途 |
|---|---|---|---|---|
| 公開 AI サービスをそのまま使う | モデルの学習データ | 社内の新しい規定を知らない | 示せない | 一般的な文章作成、翻訳、アイデア出し |
| モデルのファインチューニング | データをモデルに学習させる | 再学習が必要 | 示せない | 決まった文体、形式、分類タスク |
| RAG ナレッジベース | 回答のたびに社内文書を検索 | 文書を更新するだけ | 示せる | 社内規程、製品情報、問い合わせ対応 |
多くの企業が求めているのは「最新の社内規定に基づき、根拠を示して答える」ことなので、最初の一歩としてはファインチューニングより RAG が向いています。生成 AI、RAG、AI エージェントの違いは、企業の AI 導入:GenAI、RAG、AI エージェントの違いをご覧ください。
RAG ナレッジベースに向いている用途は?
向いている用途には、答えが文書に書かれている、質問する人が多い、誤答を人が判断できる、という 3 つの共通点があります。代表例は社内手続きの照会、問い合わせ対応の FAQ、営業向けの製品情報で、文書がそろっていて効果も測りやすい分野です。
| 用途 | 利用者 | 主な文書 | 誤答の影響 | 進め方 |
|---|---|---|---|---|
| 社内手続き・規程の照会 | 従業員 | SOP、業務マニュアル、社内規程 | 小:従業員が自分で判断できる | 最初の用途に最適 |
| 営業の製品・条件の照会 | 営業、店舗スタッフ | 製品仕様、価格表、契約書ひな形 | 中:誤りが顧客に影響する | 出典を示し、重要事項は人が確認 |
| 問い合わせ対応の FAQ | オペレーターまたは顧客 | FAQ、業務規程、お知らせ | 中:誤答で苦情が増える | まずオペレーター向けに使い、安定してから顧客向けへ |
| 法令順守・契約の一次確認 | 法務、コンプライアンス | 法令、通知、契約書 | 大:判断ミスに法的責任が伴う | AI は比較と要約のみ、判断は人が行う |
向いていない用途も先に除外しておきます。リアルタイムの計算や取引データが必要な質問(「私の保険はあといくら残っているか」など)は、文書だけでなくシステムの API 連携が必要です。文書同士が矛盾し、誰も保守していない分野も、作っても正確には答えられません。顧客向けの AI 対応については AI カスタマーサポートをご覧ください。
RAG ナレッジベースの導入ではどんなデータを準備する?
準備すべきなのは「担当者が決まった文書リスト」です。どの文書を入れるか、どれが現行版か、誰が更新し、誰が閲覧できるかを決めます。文書の整理は通常、プロジェクト前半で最も手間がかかり、精度を左右する要素でもあります。
実際には、モデルの問題より文書の問題のほうがはるかに多く見られます。
- 版の重複: 同じ規程に 2023 年版、2024 年版、「改正案」があると、AI が古い版を検索して誤答します。運用開始前に、現行版だけを入れるか、文書に施行日を明記するかを決めます。
- 解析しにくい形式: 画像としてスキャンされた PDF、セル結合の多い Excel、スライドのノートに埋もれた説明は、まず読み取れるテキストと表に変換する必要があります。
- 担当者がいない: 文書が改訂されてもナレッジベースを更新する人がいなければ、数か月で回答が古くなります。文書の種類ごとに担当部署を決めます。
- 書かれていない知識: ベテランが「知っている」だけで文書化されていないルールは、AI にはわかりません。導入を機に文書化するケースがよくあります。
まず 1 つの部署、数十〜数百件の文書で PoC を行い、精度を確認してから範囲を広げることをお勧めします。
RAG ナレッジベースの権限と個人情報はどう扱う?
権限は検索の段階で絞り込みます。利用者の身元に応じて検索できる文書を決め、その中からだけ AI に回答させます。すべての文書を検索してから最後にマスクする方法では、機密内容が回答に入り込むおそれがあります。
OWASP は 2025 年版の「LLM アプリケーションのトップ 10 リスク」で、機密情報の開示と、ベクトルと埋め込み(Embedding)の弱点をいずれもリスクとして挙げています。後者には、ベクトルデータベースのアクセス制御が不十分で、閲覧すべきでない内容を利用者が取得できてしまう問題が含まれます。プロジェクトでは次の対応になります。
| リスク | 起こること | 対策 |
|---|---|---|
| 権限外の検索 | 一般社員が管理職向けの給与や人事規定について回答を得てしまう | 文書に権限タグを付け、ログイン中の利用者に応じて検索時に絞り込む |
| 個人情報の漏えい | 顧客の氏名、身分証番号、口座番号が回答に出たり、外部モデルに送られたりする | 登録前に個人情報をマスクまたは除外し、質問の送信前にも検出して止める |
| 指定環境外へのデータ流出 | 社内規定に合わないクラウドサービスに文書が送られる | モデルサービスのデータ利用条件を確認し、法人向けプランやプライベート環境を使う |
| 追跡できない | 問題が起きたとき、AI が何を根拠に答えたのかわからない | 質問、取得した箇所、回答のログを残す |
台湾の「個人資料保護法」は、個人情報の収集・処理・利用を特定の目的の範囲内で行うよう定めています。個人情報を含む文書をナレッジベースに入れる前に、その用途が当初の目的の範囲内かを確認し、判断がつかない場合は除外します。
RAG ナレッジベースの精度はどう検証する?
同じ実際の質問セットで、回答精度、出典が正しいか、文書に書かれていない内容を聞かれたときに正直に「わからない」と答えるか、の 3 点を検証します。検証用の質問は開発前に決め、デモ用に選んだ質問は使いません。
NIST が 2024 年に公表した生成 AI のリスクプロファイル(AI 600-1)は、生成 AI がもっともらしいが誤った内容を生成しうると指摘しています。RAG はこのリスクを下げますが、なくすわけではないため、受け入れテストには「答えられないときにどうするか」も含めます。推奨する手順は次のとおりです。
- 実際の質問を集める。 問い合わせ履歴、社内の照会メール、社員へのヒアリングから 100〜300 問を集め、正解と引用すべき文書を記録します。
- 質問の種類を分ける。 明確な答えがある質問、複数の文書をまとめる必要がある質問、文書に書かれておらず回答を控えるべき質問を含めます。
- 基準を決める。 回答精度、出典の正確さ、回答を控える判断の正しさをそれぞれどこまで求めるか、業務部門と IT 部門で一緒に決めます。
- 調整のたびに再テストする。 文書の分割方法、検索設定、プロンプトを変えたら、同じ質問セットで再実行して前後を比較します。
- 運用開始後も質問を集め続ける。 利用者から誤答として報告された質問をセットに加え、定期的に再テストします。
企業の RAG ナレッジベースの費用と期間は?
JoinX の台湾での相場では、単一用途の PoC が約 30 万〜80 万台湾ドル、本番運用が約 80 万〜250 万台湾ドルです。モデル API とサーバー費用は利用量に応じて別途かかります。
要件相談は無料で、部署横断・複数システムは範囲に応じて見積もります。
| 段階 | 費用の目安 | 主な内容 | 期間の目安 |
|---|---|---|---|
| 要件相談 | 無料 | 業務とデータを把握し、AIが向いているかを判断して、最初の場面を提案 | 1〜2 回の打ち合わせ |
| 単一用途の PoC | 30 万〜80 万台湾ドル | 1 部署の文書、基本的な検索と質問応答の画面、質問セットによる検証 | 4〜8 週間 |
| 本番運用(単一用途) | 80 万〜250 万台湾ドル | アカウントと権限の連携、文書更新の流れ、操作ログ、監視とデプロイ | 2〜4 か月 |
| 部署横断・複数システム | 範囲に応じて見積もり | 複数のナレッジベース、業務システムの API 連携、AI エージェントの流れ | 4 か月以上 |
金額を左右するのは主に 3 点です。文書の量と整理の難しさ、権限ルールの複雑さ、そしてどの既存システム(社員アカウント、文書管理システム、問い合わせ管理システムなど)と連携するかです。上記は予算計画の出発点であり、確定した見積もりではありません。
JoinX は企業の RAG ナレッジベースをどう作る?
JoinX は開発前に検証用の質問と権限ルールを決め、実際の質問に正確に答えられ、閲覧できない文書は検索されないことを確認してから範囲を広げます。
開発プロセスは SDD と TDD を採用しており、検証用の質問セットはテストの一部として、調整のたびに再実行できます。
ある保険会社の AI アシスタント基盤では、いくつかの要件を最初から設計に組み込みました。回答には必ず根拠となった文書の箇所を示し、担当者が原文に戻って確認できるようにすること。検索時に利用者の権限で文書を絞り込むこと。質問をモデルに送る前に個人情報を検出して止めることです。同じ保険会社の AI エージェントの画面は、第一線の営業担当者の作業順序に沿って設計し、AI が情報の照会と整理を手伝い、最後は人が確認する形にしました。詳しくは保険会社の AI エージェント事例をご覧ください。
納品前に、JoinX はソースコードスキャンと脆弱性スキャンを自社で実施します。ブラックボックステストは第三者が行い、JoinX が手配を支援し、脆弱性を修正してから納品します。運用開始後の文書更新の流れ、質問セットの再テスト、モデルのバージョン変更についても、納品時にあわせて引き継ぎます。
よくある質問
企業向けのナレッジベース・チャットボットと RAG は同じもの?
多くの場合は同じです。現在「企業のナレッジベース・チャットボット」と呼ばれるものの多くは RAG で作られています。利用者がチャット形式で質問すると、システムが社内文書を検索し、AI がその結果に基づいて回答します。キーワードの一致で決まった回答を返す従来型の FAQ ボットは RAG ではなく、あらかじめ設定した質問にしか答えられません。
すでに生成 AI を使っている。次に RAG を導入するには、チームにどんな能力が必要?
3 つの役割が必要です。文書と業務を理解し、文書の整理と検証用の質問作成を担う人、アカウント、権限、システム連携を担う IT、そして基準と公開範囲を決められる責任者です。開発やモデルの調整は外部に委託できますが、文書の担当と受け入れ基準は自社で持たないと、運用開始後に保守できなくなります。
RAG ナレッジベースはまったく間違えないようにできる?
できません。RAG は回答を社内文書に基づかせ、出典を示すことで、根拠のない回答を大きく減らしますが、正しい箇所を検索できなかったり、文書自体が誤っていたりすれば誤答は起こります。そのため、出典を示して人が確認できるようにし、リスクの高い質問は人に引き継ぎ、誤答した質問をセットに加えて再テストし続けます。
ナレッジベースに入れた文書は、モデルの学習に使われる?
利用するモデルサービスとプランによります。多くのクラウドモデルの法人向けプランや API の規約では、顧客データを既定では学習に使わないと定めていますが、規約は事業者ごとに異なります。導入前に、データの保存場所、保存期間、利用範囲を一つずつ確認してください。機密性の高い文書は、プライベート環境での運用を検討するか、ナレッジベースから外します。
RAG ナレッジベースの運用開始後にかかる費用は?
主にモデル API の利用料、サーバーとベクトルデータベースの費用、保守の人件費です。利用料は質問数に応じて増え、保守には文書の更新、再テスト、モデルのバージョン変更、システムの修正が含まれます。本番運用の前に、PoC 期間の質問数から月々の利用量を見積もっておくことをお勧めします。
参考資料
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(NeurIPS 2020)Patrick Lewis ほか、Facebook AI Research
- OWASP Top 10 for LLM Applications 2025OWASP Foundation
- Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile(NIST AI 600-1、2024 年)米国国立標準技術研究所(NIST)
- 個人資料保護法(台湾)台湾法務部(全国法規資料庫)
上記は執筆時点で引用した法令・資料です。改正される場合がありますので、実際の適用は所管官庁の最新の公告をご確認ください。
著者について
李秉哲(Jack Lee)
JoinX 創業者兼CEO
2016年にJoinXを創業。台湾と日本にまたがる80名以上のチームを率い、220社以上のお客様に520件以上のプロジェクト(うち中・大規模システム56件)を提供してきました。
Jackについて