技術情報
AI導入はなぜ失敗するのか?5つの典型パターンと立て直しの実務
企業のAI導入が失敗する原因の多くは、技術ではありません。デモの落とし穴、データの未整備、責任者の不在、ユースケースの選定ミス、検収基準の欠如です。本記事では、プロジェクト立て直しの事例から5つの失敗パターンと対応策を整理します。
目次
企業のAI導入が失敗するのは、多くの場合、モデルの回答が十分に賢くないからではなく、プロジェクトの当初から業務上のユースケース、データの責任体制、検収方法が明確になっていないからです。 モデルを変えればデモの見栄えは良くなるかもしれませんが、権限、業務フロー、組織の問題が自然に解決するわけではありません。
以下の5つのパターンは、企業プロジェクトの立て直しで繰り返し見られる状況をまとめたものです。事例は一般化して整理しており、特定のお客様を指すものではありません。パートナー選びを進めている方は、先に2026年版 AI導入会社の選び方ガイドもあわせてご覧ください。
AIのデモは見事なのに、なぜ本番の業務に入れないのか?
デモで検証できるのは通常ひとつのシナリオだけですが、本番の業務では権限、例外、システム連携、責任の所在まで扱う必要があります。最初に運用条件を定義していなければ、デモの成果をそのまま本番稼働につなげることはできません。
よくある状況
チームが厳選した少数の文書で見栄えの良いQ&Aを作り、経営層もデモを評価します。ところが本番稼働の準備に入ってから、ログインと権限、データ更新、出典の提示、監視、コスト上限、人による引き継ぎの仕組みがないことに気づきます。
注意すべき兆候
- テストデータはプロジェクトチームが手作業で整理したもので、正式なデータソースとはつながっていない。
- 成功した質問だけを見せており、失敗、回答不能、権限外のケースが含まれていない。
- 実際の利用者、障害対応の窓口、本番稼働の責任者がいない。
予防と立て直し
PoCの前に、本番稼働のチェックリストを作成します。利用者、データソース、権限、システム連携、リスク、監視、検収です。デモは小さくてもかまいませんが、アーキテクチャの判断は実環境にどう載せるかを前提に行う必要があります。
データが整備されていないと、AIプロジェクトはどう失敗するのか?
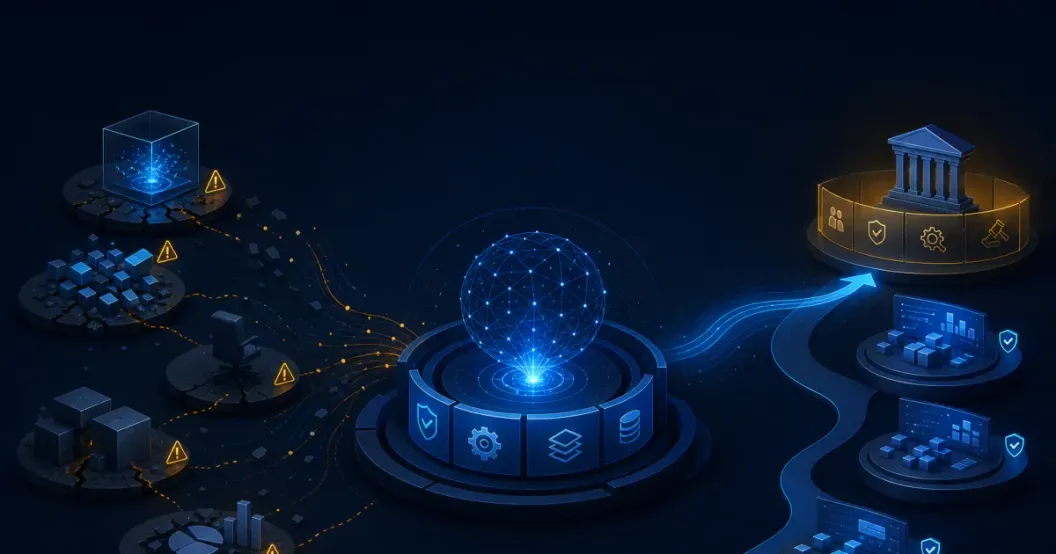
AIは既存データの欠落、矛盾、権限の問題を増幅します。モデルを変えるよりも、まずデータソース、品質、責任のルールを整えるほうが、結果の改善につながることが一般的です。
よくある状況
部門ごとに文書のバージョンが食い違い、分類も統一されておらず、権限や保存期間も不明確なまま、AIが自動的に整理して唯一の答えを出すことを期待してしまいます。その結果、誤った回答に遭遇した利用者はすぐに信頼を失います。
注意すべき兆候
- どのシステムや文書が正式なソースなのか答えられない。
- コンテンツの更新や古い情報の削除を担当する人がいない。
- テストが失敗してもプロンプトを修正するしかなく、データソースまでさかのぼれない。
予防と立て直し
まずひとつのデータ領域を選び、オーナー、バージョン、権限、更新ルールを定義します。そのうえで最小限の実用データセットと固定のテスト質問を用意します。データガバナンスを一度に全社で完成させる必要はありませんが、現在のユースケースについては責任を持てる状態にしておく必要があります。
失敗パターン3:業務側の責任者がいない
よくある状況
AIプロジェクトが情報システム部門やイノベーション推進チームに任され、業務部門はデモのときに意見を出すだけになっています。例外処理の進め方、許容できる誤りの程度、内容の正しさ、本番稼働後の使い方を決められる人がいません。
注意すべき兆候
- 会議には多くの関係者が参加するが、最終的な意思決定者がいない。
- 技術チームが業務ルールを自分たちで判断するよう求められている。
- 本番稼働後、利用定着度、フィードバック、内容の改善を追跡する人がいない。
予防と立て直し
権限を持つ業務側のオーナーを指名し、ユースケース、データ、成果に責任を持ってもらいます。情報システム部門はアーキテクチャ、セキュリティ、運用体制を担います。意思決定、データ、モデル、システムのそれぞれに明確なオーナーが必要です。
失敗パターン4:最初のユースケースが大きすぎる
よくある状況
第1期で全社のナレッジ基盤、自動顧客対応、営業提案、業務分析をまとめて構築し、AIの戦略的価値を一気に証明しようとします。部門ごとにルールが異なり、最終的にはどれひとつとして完全に検収できません。
注意すべき兆候
- 要件が「すべての文書」「全従業員」「あらゆる質問」といった言葉で語られている。
- 権限、データ、システム連携が、まだ調整のついていない複数の部署にまたがっている。
- 単独で本番稼働できる最初のマイルストーンがない。
予防と立て直し
対象を、ひとつの利用者グループ、ひとつの質問の種類、ひとつのデータ領域、ひとつの業務成果に絞り込みます。最初のユースケースは、安全に失敗でき、人がレビューでき、短いサイクルで実際の根拠を積み上げられるものであるべきです。
ベースラインと検収基準がないと、AIプロジェクトはどうなるのか?
現状のベースラインがなければAIが改善をもたらしたかどうかを証明できず、検収基準がなければいつ本番稼働するかも決められません。その結果、プロジェクトは主観的な評価と調整の繰り返しにとどまりがちです。
よくある状況
チームは「AIの回答が良さそうに見えるか」だけを問い、元の業務にどれだけ時間がかかり、どこで誤りが起きているかを測っておらず、固定のテストセットもありません。モデルやプロンプトを更新するたびに、品質を印象で議論するしかなくなります。
注意すべき兆候
- 導入前の時間、コスト、誤り、利用状況のデータがない。
- テストの質問が毎回異なり、バージョン間で比較できない。
- 正答率だけを測り、人による引き継ぎ、権限、セキュリティ、1回あたりのコストを測っていない。
予防と立て直し
開発前に現状のベースラインを把握し、成功をタスク完了、品質、時間、人手、リスク、コスト、利用定着度に分解します。繰り返し実行できる評価セットを作り、実際の業務フローでの検収も加えます。
AIプロジェクトを立て直す5つのステップ
JoinXの立て直し経験から言えるのは、最初にすべきことはすぐにモデルを入れ替えることではなく、目標、現状、責任の所在を改めて確認することです。失敗がどの層で起きているかを先に特定してはじめて、その後の調整に検収可能な根拠が生まれます。
1. 範囲を定義し直す
「AIを導入する」を、特定の利用者が特定の業務で改善したい成果に言い換え、対象外のデータと操作を明記します。
2. 最小限の実用データを用意する
ユースケースの検証に十分で、権限とバージョンを確認できるデータセットを選びます。ソース、更新、失効のルールは残しつつ、最初からすべてのコンテンツをそろえようとはしません。
3. エンジニアリングの基盤を整える
環境、バージョン管理、権限、ログ、監視、テスト、コスト、人による引き継ぎの仕組みを整え、すべての変更を追跡でき、失敗時には安全に停止できるようにします。
4. 測定の仕組みを作り直す
導入前後を同じ方法で比較し、固定のテストセットを作ります。回答の品質だけでなく、業務の完了、権限によるブロック、例外からの復旧、運用コストもテストします。
5. 段階的に本番稼働させる
まず少数の実際の利用者に、人によるレビューのもとで使ってもらい、誤りの種類や利用状況に応じて段階的に拡大します。拡大のたびに、明確な開始条件と停止条件を設けるべきです。
新しいモデルで古い問題を覆い隠さない
モデルの能力は今後も向上し続けますが、次の問題はアップグレードしても自然には消えません。
- データにオーナーがいない。
- 利用者の権限が明確でない。
- 業務フローそのものに矛盾がある。
- システムを監視できず、ロールバックもできない。
- 組織に意思決定と継続的改善の仕組みがない。
まずこれらの基盤を整えてからモデルを比較することで、改善がどこから生まれたのかを把握できます。導入の全体的なフェーズについては2026年版 企業向けAI導入サービスガイドを、技術の選び方については企業AI・生成AI・RAG・AIエージェントの全解説もあわせてご覧ください。
まとめ:失敗を検証可能な次の一手に変える
すでに行き詰まっているプロジェクトを、すべて捨てる必要はありません。まず問題がユースケース、データ、責任体制、エンジニアリング、検収のどこにあるかを切り分け、使えるヒアリング結果、テストデータ、インターフェース、連携の成果を残したうえで、より小さな範囲で根拠を積み上げ直します。
立て直しの目的は、無理に成功を宣言することではありません。継続するか、調整するか、いったん止めるか、どのような条件で拡大するかを判断できる状態を、企業に取り戻すことです。
AI導入の失敗に関するよくある質問
AI導入で最も多い失敗の原因は何ですか?
よくあるのは、デモの落とし穴、データの未整備、業務側の責任者の不在、大きすぎるユースケース、検収のベースラインの欠如です。
AIのデモが成功しても、なぜそのまま本番稼働できないのですか?
本番のシステムでは、権限、システム連携、監視、例外処理、コスト、セキュリティ、継続的な更新にも対応する必要があるためです。
データが整理されていなくてもAIに取り組めますか?
管理可能な小さなデータセットで検証を始めることはできますが、オーナー、バージョン、権限の整備を同時に進める必要があります。
AIプロジェクトは情報システム部門が担当すべきですか?
情報システム部門は技術面のガバナンスを担いますが、業務部門も業務フローと成果を決められるオーナーを指名する必要があります。
最初のAIユースケースはどう選べばよいですか?
発生頻度が高く、範囲が明確で、データが入手でき、結果を検証でき、誤りの影響を抑えられる業務を選びます。
AI導入の検収はどのように行えばよいですか?
まず現状のベースラインを把握し、そのうえでタスク、品質、時間、人手、権限、コスト、利用定着度を測定します。
失敗したAIプロジェクトは作り直すしかありませんか?
必ずしもそうではありません。有効な資産を残して範囲を絞り、データ、エンジニアリング、検収のベースラインを作り直すことができます。
JoinXはAIプロジェクトの立て直しをどう支援しますか?
JoinXはまずユースケース、データ、システム、ガバナンスを診断し、最小限のデータ、エンジニアリングの基盤、段階的なリリースによってプロジェクトを再構成します。
著者について
李秉哲(Jack Lee)
JoinX 創業者兼CEO
2016年にJoinXを創業。台湾と日本にまたがる80名以上のチームを率い、220社以上のお客様に520件以上のプロジェクト(うち中・大規模システム56件)を提供してきました。
Jackについて